
Наблюдатель выбирает не так, как список
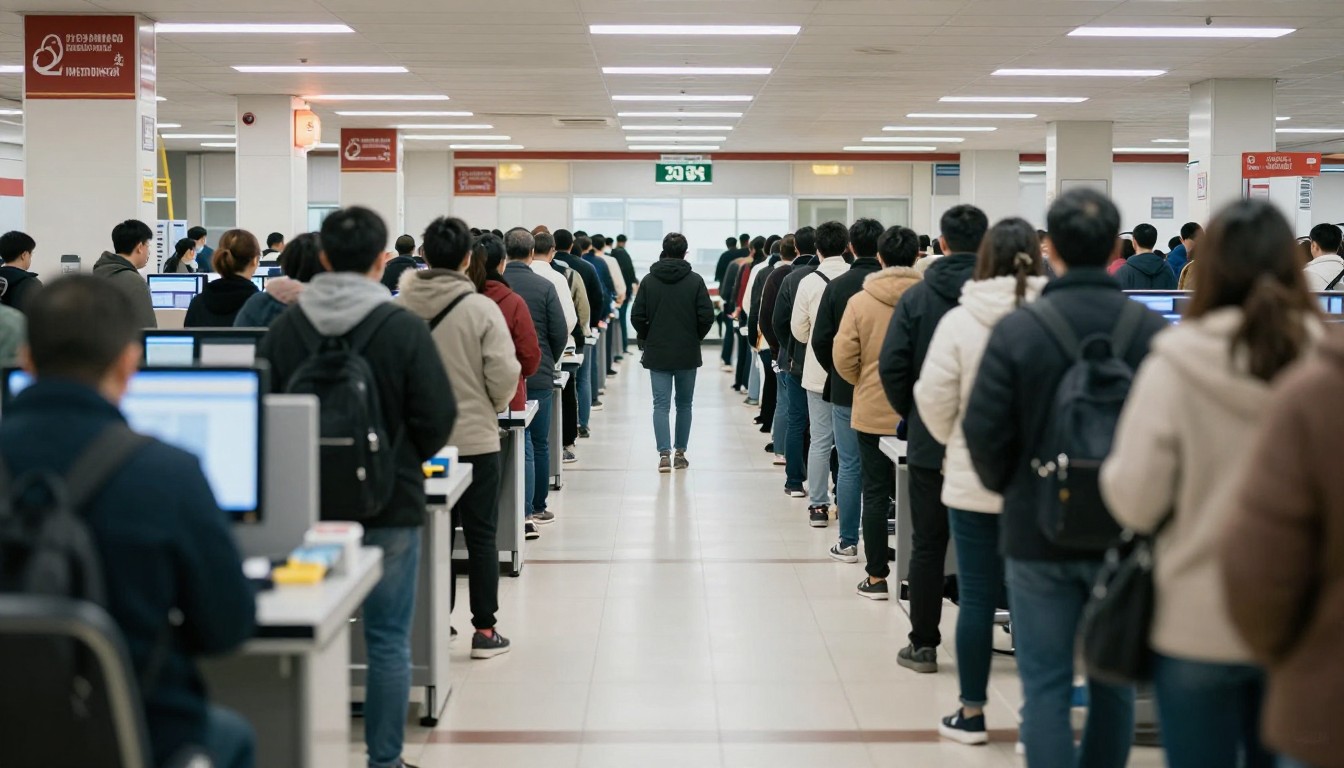
Представьте зал ожидания с тремя очередями: в первой стоят два человека, во второй — четыре, в третьей — восемь. Если выбрать одну очередь наугад из списка, у каждой будет одинаковый шанс — одна треть. Но если спросить, в какой очереди случайно выбранный посетитель окажется чаще, ответ изменится: большинство людей стоит в самой длинной очереди.
Это различие возникает из-за способа выбора. В первом случае случайно выбирают очередь, во втором — человека, а затем смотрят, где он стоит. Каждая очередь получает тем больше шансов быть замеченной, чем больше в ней людей. Поэтому наблюдения с разных точек зрения дают разные результаты, хотя сами очереди не меняются.
Такой эффект называют смещением выборки, связанной с размером группы. Он не означает, что длинная очередь всегда вероятнее или что коротких очередей мало. Он показывает, что вероятность попасть в группу зависит от того, выбираем ли мы группу напрямую или встречаем её через одного из участников.
Подсчёт на простом примере
Вернёмся к очередям из двух, четырёх и восьми человек. Если выбрать одну очередь равновероятно, шанс выбрать очередь из восьми человек — одна треть. Но среди всех посетителей всего четырнадцать человек, и восемь из них находятся в самой длинной очереди. Значит, случайно выбранный посетитель окажется там с вероятностью восемь четырнадцатых.
Для очереди из двух человек вероятность при выборе посетителя равна двум четырнадцатым, для очереди из четырёх — четырём четырнадцатым. Вероятности складываются в единицу, потому что каждый посетитель принадлежит ровно одной очереди. В общем случае шанс попасть в конкретную группу пропорционален её размеру: нужно разделить число участников группы на общее число участников.
Важно не смешивать эти два вопроса: «Какова вероятность выбрать эту очередь?» и «Какова вероятность оказаться в ней, если я случайный посетитель?» Первый относится к группам, второй — к людям. Они совпали бы, только если бы все очереди были одинакового размера.
Где ещё встречается такой перекос
Похожая логика действует в аудитории. Если случайно выбрать учебную группу, у небольшой и большой группы может быть одинаковый шанс попасть в выборку. Если же случайно встретить студента в коридоре и узнать, в какой он группе, большие группы будут представлены чаще: в них просто больше людей, которых можно встретить.
Ещё один пример — дома в районе. Случайный выбор дома даёт каждому зданию одинаковый шанс, если правило выбора именно такое. Но случайно встреченный житель с большей вероятностью окажется из дома с большим числом жильцов. Поэтому опрос жителей и опрос домов отвечают на разные вопросы, даже если разговор в обоих случаях касается «типичного дома».
Подобная разница возникает и в опыте с размерами семей или компаний. Если опросить случайно выбранных людей, семьи с большим числом участников чаще попадут в ответы. Это не обязательно ошибка: такой опрос хорошо описывает то, в каких семьях живут люди. Но он может плохо отвечать на вопрос о типичном размере семьи, выбранной из списка семей.
Почему усреднение может сбивать с толку
Допустим, в одном районе есть много маленьких семей и несколько очень больших. Средний размер семьи при равном весе каждой семьи отвечает на вопрос: сколько человек приходится на среднюю семью? Если же усреднить размер семьи, в которой живёт случайно выбранный житель, большие семьи будут учитываться чаще. Получится другая величина — размер семьи типичного жителя.
Ни одно из этих средних не является автоматически правильным или неправильным. Они описывают разные способы смотреть на население. Ошибка возникает, когда результат одного способа представляют как ответ на другой вопрос. Например, данные о жителях нельзя без оговорок трактовать так, будто исследователь случайно выбирал семьи.
В бытовых наблюдениях это тоже полезно помнить. Если кажется, что везде встречаются особенно людные компании, возможно, именно такие компании чаще попадают в поле зрения: в них больше людей, а значит, больше потенциальных встреч. Само впечатление может быть честным описанием личного опыта, но оно не обязательно показывает, как распределены группы в целом.
Как читать подобные наблюдения
Перед тем как делать вывод по наблюдению, полезно уточнить единицу выбора: человека, группу, дом или событие. Затем стоит спросить, получают ли большие группы больше возможностей попасть в выборку. Если да, результат может быть сдвинут в их сторону — не из-за чьей-либо ошибки подсчёта, а из-за устройства отбора.
Это особенно важно, когда сравнивают впечатление очевидца со списком объектов. Случайный прохожий чаще встретит крупную компанию, а случайно выбранная из перечня компания не обязана быть крупной. Случайно выбранный житель чаще окажется в многолюдном доме, а случайно выбранный дом не получает дополнительного веса из-за числа жильцов.
Главный вопрос здесь — не только «что я наблюдаю?», но и «каким образом я это наблюдаю?» Разница между выбором группы и встречей с её участником может незаметно изменить вероятность, среднее и ощущение того, что типично. Когда способ отбора назван точно, кажущийся парадокс превращается в понятный результат подсчёта.
Материал подготовлен с использованием ИИ. Информационная публикация, не руководство по участию в азартных играх.